
Disponibilidade e redundância em teleproteção: rotas, canais e failover
Projete canais A/B realmente independentes, elimine falhas comuns, defina estado degradado e valide comutação, retorno e manutenção.
Auditoria de independência dos canais A/B
| Camada | Canal A | Canal B | Falha comum a excluir | Teste |
|---|---|---|---|---|
| Proteção | Relé/I/O/fusível | Relé/I/O/fusível | Mesmo hardware ou saída | Inibir um sistema |
| Alimentação | Banco/quadro/disjuntor | Banco/quadro/disjuntor | Barra ou fusível comum | Perda de cada fonte |
| Acesso | Porta/ODF/fibra | Porta/ODF/fibra | Patch panel ou cabo comum | Rompimento controlado |
| Transporte | Nós e rota | Nós e rota | Nó, clock ou software comum | Falha de nó/clock |
| Físico | Duto/torre/edificação | Duto/torre/edificação | Evento ambiental único | Inspeção de rota |
| Gestão | Configuração/acesso | Configuração/acesso | Mudança ou credencial comum | Rollback independente |
Disponibilidade da proteção é maior que disponibilidade do link
O serviço depende de medição, relés, lógicas, I/O, telecom, alimentação, disjuntores, sincronismo e configuração. Um backbone com cinco noves não garante teleproteção se ambos os terminais compartilham fonte, cartão ou patch cord. Defina disponibilidade na fronteira funcional: capacidade de executar o esquema dentro do tempo e segurança requeridos.
Métricas devem separar indisponibilidade anunciada, falha oculta e modo degradado. Um canal pode estar up e entregar atraso incompatível; uma proteção pode continuar por retaguarda, mas sem velocidade principal. O painel operacional precisa mostrar essa perda de função.
Redundância começa pela análise de falha comum
Liste TCs/TPs, enrolamentos, relés A/B, fontes CC, fusíveis, painéis, I/O, fibras, ODFs, cabos, dutos, multiplexadores, switches, clocks, software e acesso de engenharia. Para cada par redundante, marque componentes compartilhados. IEEE C37.120 orienta a seleção de nível de redundância considerando confiabilidade do sistema.
Diversidade verdadeira pode exigir separação física, tecnológica e organizacional. Duas VLANs no mesmo hardware mitigam erro de domínio, não falha de switch. Dois cabos no mesmo duto mitigam rompimento de fibra individual, não escavação. Declare explicitamente qual ameaça cada duplicação cobre.
Arquiteturas A/B e lógica de decisão
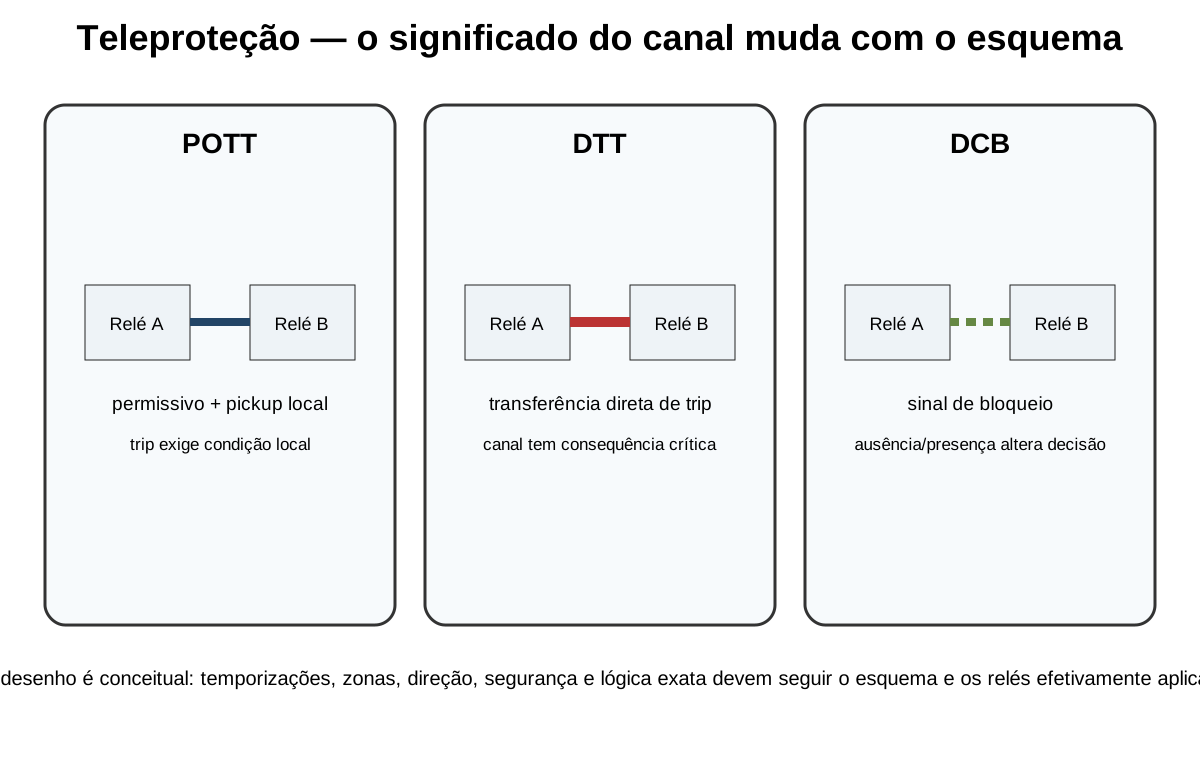
Pode haver dois canais para o mesmo relé, dois relés com canais próprios ou esquemas principais diferentes. Decida se basta qualquer canal, se existe votação, preferência, hot standby ou operação simultânea. Duplicar sinais de trip sem controle pode aumentar exposição a atuação espúria.
A lógica deve distinguir perda de um caminho, discrepância entre caminhos e perda total. Alarmes precisam identificar qual proteção permanece disponível. Manutenção em A não deve desabilitar B por interlock comum ou arquivo compartilhado não previsto.
Failover tem tempo, perda e transientes
Comutação não é instantânea por definição. Detectar falha, selecionar rota, reconvergir, estabilizar clock e revalidar canal consomem tempo. PRP/HSR, SDH protection, MPLS fast reroute e protocolos de rede têm mecanismos diferentes. O requisito deve considerar o esquema de proteção, não apenas o SLA do transporte.
Meça comandos perdidos durante a transição, atraso por direção e comportamento do relé. Um canal diferencial pode bloquear ao detectar mudança; um permissivo pode simplesmente atrasar. Teste na carga e no pior caminho. O máximo observado e sua repetibilidade importam mais que a média.
Retorno automático pode ser mais arriscado que failover
Quando a rota principal retorna intermitente, revertive switching pode provocar flapping. Mudar de volta também pode alterar assimetria e clock. Holdoff, wait-to-restore e critérios de estabilidade precisam ser definidos. Nem sempre retornar automaticamente é melhor; operação não revertiva pode ser mais previsível.
Teste restauração repetida, não apenas uma volta limpa. Verifique se alarmes latched preservam a ocorrência, se a proteção rearma após qualidade estável e se não existe pulso de saída. Documente ação manual para estado preso ou divergente.
Manutenção e falha latente
Redundância só tem valor se ambos os caminhos forem periodicamente provados. Um standby nunca exercitado pode estar indisponível há meses. Planeje testes alternados, inspeção de alarmes, potência óptica, baterias, clocks e configuração. Manutenção deve preservar pelo menos a função mínima ou declarar risco operacional.
Mudanças simultâneas em A e B eliminam independência de configuração. Use janelas separadas, revisão e rollback. Credenciais, servidor de licenças e sistema de gestão também podem ser pontos únicos. Cibersegurança deve permitir acesso de emergência controlado sem criar conta compartilhada permanente.
Alarmes, indicadores e decisão operacional
Defina alarmes por perda de A, perda de B, degradação de atraso, assimetria, clock, discrepância e perda total. Prioridade deve refletir função remanescente. Um alarme genérico “telecom” não informa se a linha perdeu aceleração, diferencial ou apenas gestão. Vincule cada estado a restrição, prazo de reparo e eventual retirada de serviço.
Indicadores úteis incluem horas em modo degradado, falhas ocultas encontradas em teste, MTTR por domínio, comutações, flapping e intervenções com ambos os caminhos afetados. Tendências revelam fragilidade antes de ocorrência. Disponibilidade deve orientar manutenção e investimento, não ser apenas porcentagem mensal.
Defina ainda um tempo máximo permitido em modo degradado e quem pode aceitá-lo. A existência de retaguarda temporizada não torna ilimitada a permanência sem esquema principal. Se o reparo ultrapassar o prazo, operação e proteção precisam reavaliar carregamento, topologia e exposição. Essa decisão deve ficar registrada com condição de encerramento e confirmação de que a redundância voltou a ser efetiva.
- Separar canal perdido, canal degradado e proteção totalmente indisponível nos alarmes.
- Relacionar cada estado à retaguarda ativa, restrição operacional e prazo de reparo.
- Medir tempo entre falha, detecção, reconhecimento e restauração funcional completa.
- Auditar mensalmente permanência indevida em canal único ou rota de contingência.
- Usar falhas encontradas em teste para revisar cobertura de supervisão e periodicidade.
Cálculo com hipóteses transparentes
Disponibilidade aproximada combina MTBF e MTTR, mas componentes não são sempre independentes. Modelos em série/paralelo ajudam a comparar, desde que incluam falhas comuns e cobertura de detecção. Use dados históricos locais, fabricante e premissas declaradas. Um número com muitas casas não compensa hipótese falsa.
Converta resultado em risco funcional: horas anuais sem teleproteção rápida, probabilidade de manutenção simultânea, tempo até detectar falha oculta e retaguarda disponível. Isso permite priorizar diversidade, sobressalentes, treinamento ou redução de MTTR.
Teste e evidência de resiliência
Execute perda de cada fibra, porta, cartão, nó, fonte e referência de tempo autorizada. Registre alarmes, rota, canal ativo, atraso, perdas e proteção remanescente. Depois teste falhas combinadas plausíveis e manutenção. Todos os casos precisam de plano seguro e coordenação operacional.
O aceite deve incluir retorno, flapping e persistência de alarmes. Atualize diagrama com caminho realmente observado. Se a rota declarada A reaparece pelo mesmo duto de B, a auditoria encontrou uma falha de projeto, não um detalhe de documentação.
Referências técnicas e normas
As explicações do Portal são autorais. Normas e fontes oficiais são priorizadas; materiais acadêmicos e documentação pública de fabricantes complementam a implementação e não substituem a edição normativa aplicável ao projeto.
- IEC 60834-1:1999 — Teleprotection equipment of power systems — Performance and testing — Command systems — IEC. Requisitos de desempenho e métodos de ensaio para sistemas de comando de teleproteção.
- IEEE C37.113-2025 — Guide for Protective Relay Applications to Transmission Lines — IEEE Standards Association. Guia vigente sobre proteção de linhas, coordenação, tempos, características e uso de canais de comunicação.
- IEEE C37.236-2013 — Guide for Power System Protective Relay Applications Over Digital Communication Channels — IEEE Standards Association. Aplicação, instalação, operação e diagnóstico de canais digitais usados por proteção.
- IEEE C37.94-2017 — Optical Fiber Interfaces between Teleprotection and Multiplexer Equipment — IEEE Standards Association. Interface óptica N × 64 kbit/s, conexão física e temporização entre teleproteção e multiplexadores.
- IEC TR 61850-90-1:2010 — Use of IEC 61850 for communication between substations — IEC. Casos de uso, requisitos e arquitetura para troca de informações entre subestações.
- IEC TR 61850-90-12:2020 — Wide area network engineering guidelines — IEC. Diretrizes de WAN para comunicação entre subestações e centros de controle.
- IEC 60255-1:2022 — Common requirements for measuring relays and protection equipment — IEC. Requisitos comuns para relés, incluindo comunicações como parte de esquemas distribuídos de proteção.
- IEEE C37.233-2023 — Guide for Power System Protection Testing — IEEE Standards Association. Referência para planejamento, execução, documentação e avaliação de testes de proteção.
- IEEE C37.120-2021 — Guide for Protection System Redundancy for Power System Reliability — IEEE Standards Association. Níveis de redundância e dependências entre relés, TCs/TPs, comunicação, alimentação e localização física.
- IEC 62351-6:2020 — Security for IEC 61850 — IEC. Mecanismos de segurança aplicáveis aos serviços IEC 61850, relevantes quando GOOSE atravessa arquiteturas estendidas.
Continue estudando
Os próximos conteúdos foram escolhidos para formar uma sequência técnica, relacionando fundamento, configuração, diagnóstico e aplicação.