
PRP: guia prático para automação elétrica
PRP: guia prático para automação elétrica. Veja aplicações, parâmetros essenciais, critérios de engenharia, testes e diagnóstico em automação elétrica.
Desempenho/confiabilidade — o número e o que ele não diz sozinho
| Métrica | Unidade | Complemento obrigatório |
|---|---|---|
| Latência | ms | p95/p99/máximo, direção e carga. |
| Jitter | ms | Método de cálculo e correlação com fila/rádio. |
| Packet loss | % | Rajada máxima, direção e ponto de perda. |
| Throughput | kbps/Mbps | Capacidade do enlace, protocolo e janela. |
| Disponibilidade | % | Período, exclusões e critério de indisponibilidade. |
| MTBF / MTTR | tempo | Definição de falha, início/fim e amostra histórica. |
Matriz específica — PRP / visão geral
| Campo/elemento | Valor ou representação | Como fechar a evidência |
|---|---|---|
| RSTP Hello · visão geral | 2 s ref. | Capturar BPDUs e role/state. |
| Max Age / Forward Delay · visão geral | 20 s / 15 s ref. | Não confundir parâmetros com convergência real. |
| PRP · visão geral | duas LANs | Conferir duplicate/sequence e independência física. |
| HSR · visão geral | anel duplicado | Conferir sequence e continuidade após abertura. |
A matriz foi escolhida pelo foco “PRP” e pela lente “visão geral”; referências normativas e limites de fabricante continuam prevalecendo.
PRP x HSR — o que aparece na captura e no teste
| Item | PRP | HSR |
|---|---|---|
| Topologia | Duas LANs independentes A/B | Anel com envio nas duas direções |
| Recuperação | Sem espera de reconvergência para frame já duplicado | Sem espera de reconvergência para frame já duplicado |
| Identificação | RCT com sequence/LAN info | Tag/sequence HSR para eliminação de duplicatas |
| Teste decisivo | Abrir LAN A ou B e medir gap da aplicação | Abrir um segmento do anel e medir gap da aplicação |
| Falha escondida comum | Duas LANs compartilhando energia/caminho físico | Duplicação funcionando, mas nó/anel com erro de forwarding |
Antes de configurar PRP: função, fronteiras e dependências
PRP precisa ser ligado ao caminho real do tráfego em PRP: interface de ingresso, domínio L2/L3, políticas, filas e saída. O conceito deixa de ser abstrato quando uma tabela, contador ou captura permite afirmar em qual equipamento a decisão ocorreu.
No desenho de PRP, localize PRP entre origem e destino e marque quais elementos dependem de zero recovery time, PRP, LAN A. A definição deve permitir responder quem produz a informação, quem toma a decisão, onde o estado é mantido e qual evidência aparece primeiro quando algo sai do esperado.
Mecanismo de PRP: campos, estados e transições que importam
Para PRP, siga o frame/pacote salto a salto. Confirme ingresso, VLAN, decisão de switching/roteamento, política, fila e saída, usando sequence number, zero recovery time, PRP como pontos de prova. Quando o tráfego desaparece, o primeiro equipamento em que contador/captura deixa de concordar com o desenho delimita a causa.
Comprove porta física, VLAN e caminho antes de otimizar QoS ou redundância. Tabelas MAC, ARP, rotas, contadores, filas e captura devem concordar com o desenho; ping sozinho não demonstra que o fluxo de automação percorre o caminho correto. Neste artigo, acompanhe sequence number, zero recovery time, PRP, LAN A como uma cadeia causal: condição de entrada → estado interno → decisão → saída → evidência. Esse percurso evita repetir definições e obriga cada bloco do texto a acrescentar um nível novo de explicação.
Parâmetros e campos de PRP: significado, efeito e validação
Os itens abaixo não são apenas nomes de configuração. Para cada parâmetro ou campo, o artigo registra o que ele representa, o efeito prático de um valor/estado incorreto e a evidência usada para confirmar a interpretação. Valores default e faixas exatas que dependem de fabricante ou firmware devem ser confirmados na documentação do equipamento, mas a relação causa → efeito precisa permanecer válida entre implementações.
Ao alterar PRP, mude uma variável por vez e preserve o baseline. Um valor só deve ser considerado adequado quando o efeito esperado aparece na captura, no contador, no log ou no processo e quando a condição degradada continua dentro do requisito.
- sequence number — O que é: taxa de bits recebidos com erro em relação ao total observado. Efeito: Aumento de BER pode elevar retransmissões, reduzir capacidade útil e produzir intermitência na aplicação. Validar: medir BER/retries no mesmo período de perda, SNR e tráfego da automação.
- zero recovery time — O que é: elemento de engenharia relacionado a PRP dentro de PRP; deve ser identificado pela representação real usada no equipamento/protocolo. Efeito: Seu valor ou estado altera a interação com PRP; documente dependências e limite em vez de copiar um valor de outro projeto. Validar: comparar condição normal e uma alteração controlada usando VLAN como evidência objetiva.
- LAN A — O que é: elemento de engenharia relacionado a PRP dentro de PRP; deve ser identificado pela representação real usada no equipamento/protocolo. Efeito: Seu valor ou estado altera a interação com PRP; documente dependências e limite em vez de copiar um valor de outro projeto. Validar: comparar condição normal e uma alteração controlada usando rota como evidência objetiva.
- LAN B — O que é: elemento de engenharia relacionado a PRP dentro de PRP; deve ser identificado pela representação real usada no equipamento/protocolo. Efeito: Seu valor ou estado altera a interação com PRP; documente dependências e limite em vez de copiar um valor de outro projeto. Validar: comparar condição normal e uma alteração controlada usando fila como evidência objetiva.
- duplicação de frames — O que é: decisão aplicada quando a regra casa: permitir/accept, descartar/drop ou rejeitar/reject, conforme recursos do equipamento. Efeito: Drop normalmente gera silêncio; reject pode produzir resposta explícita. Isso muda o sintoma observado pelo cliente e pelo diagnóstico. Validar: correlacionar ação configurada, log de decisão e comportamento do pacote/cliente.
- DANP — O que é: elemento de engenharia relacionado a PRP dentro de PRP; deve ser identificado pela representação real usada no equipamento/protocolo. Efeito: Seu valor ou estado altera a interação com PRP; documente dependências e limite em vez de copiar um valor de outro projeto. Validar: comparar condição normal e uma alteração controlada usando latência como evidência objetiva.
Cenário prático: uma decisão de engenharia envolvendo PRP
Considere PRP em uma rede OT que transporta supervisão, eventos e gerenciamento. Antes de alterar QoS, redundância ou firewall, desenhe o caminho e confirme sequence number, zero recovery time e PRP com evidências de switch/roteador. Gere tráfego conhecido e observe MAC, VLAN, rota, fila e contadores. Se o sintoma só aparece sob carga, repita o mesmo volume e preserve máximos e drops.
O critério de aceite de PRP deve ligar a métrica de rede ao efeito sobre PRP. Para este recorte, sequence number será usado como referência e zero recovery time como dependência explícita; durante falha, compare PRP antes e depois. O objetivo não é ter “ping bom”, mas demonstrar que o fluxo certo mantém continuidade e tempo compatíveis com a função de automação.
- Definir uma condição normal de PRP e salvar a evidência associada a sequence number.
- Escolher uma única variável relacionada a zero recovery time e prever o efeito antes de alterar.
- Repetir o mesmo teste e comparar PRP nas mesmas medições ou campos.
- Registrar o critério que permite aceitar, rejeitar ou reverter a configuração de PRP.
Do primeiro contato ao modelo mental correto
Se você está conhecendo PRP agora, localize primeiro o elemento dentro de PRP: quem produz a informação, quem a consome, o que muda durante uma transação e qual evidência aparece quando algo falha. Use sequence number, zero recovery time, PRP como marcos do fluxo.
Para quem já trabalha com o assunto, a mesma visão serve para revisar fronteiras entre equipamento, protocolo e infraestrutura. O objetivo é conseguir afirmar em qual fronteira cada variável nasce e qual medição distingue comportamento normal, exceção e implementação específica de fabricante.
- Desenhar o fluxo de PRP sem depender da tela do fabricante
- Explicar onde sequence number entra e que evidência deixa
- Explicar onde zero recovery time entra e que evidência deixa
- Explicar onde PRP entra e que evidência deixa
Como demonstrar que PRP foi implementado corretamente
Valide contadores por interface, caminho, failover e comportamento sob carga.
Defina a evidência antes do teste de PRP. Para esta categoria, sinais úteis incluem MAC, VLAN, rota, fila, contador, latência. Use estado inicial conhecido, estímulo reproduzível e resultado esperado; quando houver duas pontas, registre as duas, e quando houver gateway/firewall/conversor, registre também a transformação intermediária.
- Validar sequence number em condição normal
- Forçar uma condição degradada ligada a zero recovery time
- Confirmar recuperação sem perder estado, evento ou evidência relevante
- Salvar configuração, logs/captura e horário do teste como baseline
Árvore de falhas de PRP: onde procurar antes de alterar parâmetros
A engenharia de PRP deve partir do comportamento e não da tela de configuração. Use sequence number para localizar a origem, zero recovery time para acompanhar a transição e PRP para confirmar o resultado. Descreva também um sintoma de valor incorreto e qual captura, contador, medição ou log diferencia essa hipótese das demais.
Não conclua a partir do sintoma sozinho. Para PRP, cruze pelo menos duas fontes de evidência e procure a primeira divergência. Se sequence number, zero recovery time, PRP estão corretos mas o resultado final continua errado, avance para a próxima fronteira do sistema em vez de alterar novamente um parâmetro já comprovado.
- sequence number: registre um caso saudável, um caso com falha e a diferença objetiva em rota.
- zero recovery time: registre um caso saudável, um caso com falha e a diferença objetiva em fila.
- PRP: registre um caso saudável, um caso com falha e a diferença objetiva em contador.
- LAN A: registre um caso saudável, um caso com falha e a diferença objetiva em latência.
Como o conceito se encaixa na arquitetura
A engenharia de PRP deve partir do comportamento e não da tela de configuração. Use sequence number para localizar a origem, zero recovery time para acompanhar a transição e PRP para confirmar o resultado. Descreva também um sintoma de valor incorreto e qual captura, contador, medição ou log diferencia essa hipótese das demais.
Para entender PRP, desenhe o fluxo completo dentro de PRP: origem da informação, transformação, transporte, recepção e uso final. Marque em cada etapa quais identificadores, estados e temporizações são preservados. Esse mapa transforma uma definição abstrata em arquitetura de engenharia.
Uma boa visão geral também precisa declarar limites. Pergunte o que PRP resolve, o que não resolve e de quais serviços depende. Essa distinção evita usar um mecanismo fora do seu propósito e ajuda a escolher onde medir quando o comportamento real diverge do esperado.
PRP: dados exclusivos deste recorte (visão geral)
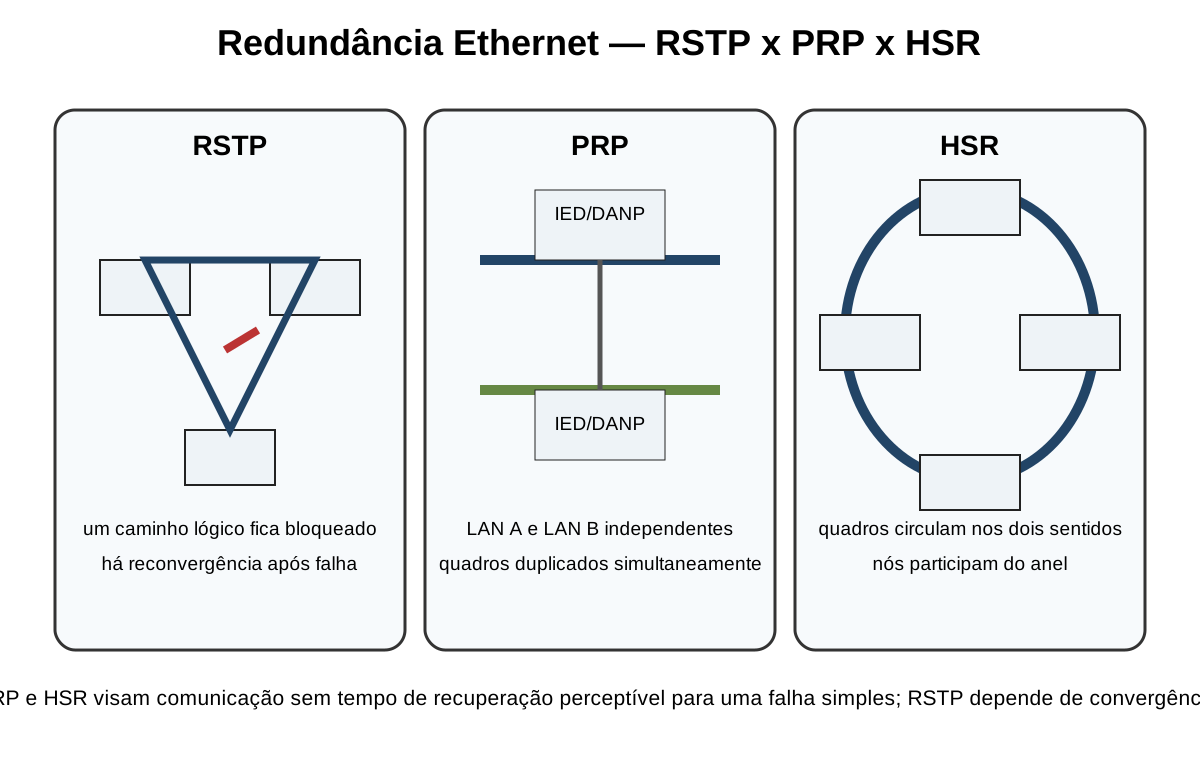
Em PRP, redundância precisa ser medida na aplicação. RSTP usa BPDUs para root/roles e valores clássicos Hello 2 s, Max Age 20 s e Forward Delay 15 s; PRP/HSR evitam esperar reconvergência ao duplicar frames. Abra um caminho e meça o maior gap entre frames úteis, não apenas o tempo de mudança da porta.
Na visão geral de PRP, o leitor deve conseguir localizar RSTP Hello e Max Age / Forward Delay no fluxo real e dizer qual componente produz cada evidência.
- RSTP Hello: 2 s ref.. Capturar BPDUs e role/state.
- Max Age / Forward Delay: 20 s / 15 s ref.. Não confundir parâmetros com convergência real.
- PRP: duas LANs. Conferir duplicate/sequence e independência física.
- HSR: anel duplicado. Conferir sequence e continuidade após abertura.
PRP: métrica, janela e efeito operacional — PRP / visão geral
No mapa funcional de PRP, use zero recovery time para localizar onde o fenômeno nasce e em qual equipamento a evidência deve aparecer. Latência deve ser tratada como distribuição, não como um único ping; jitter é variação temporal; packet loss precisa distinguir perda aleatória de rajada; bandwidth é capacidade, enquanto throughput é taxa útil. Disponibilidade deve declarar janela e exclusões; MTBF mede tempo médio entre falhas e MTTR tempo médio de restauração. O critério de encerramento para PRP em visão geral é obter o mesmo resultado em novo teste de zero recovery time, mantendo o ponto de medição e a condição inicial.
Para entender PRP sem abstração excessiva, acompanhe duplicação de frames da origem ao consumidor e marque a fronteira em que seu estado pode mudar. Para PRP, registre pelo menos média, p95/p99 ou máximo, pior rajada e tempo de recuperação quando a métrica tiver natureza temporal. Depois relacione o número ao efeito: atraso de atualização SCADA, evento fora de ordem, timeout, retry, queda de sessão ou perda de comando. Para este artigo de PRP, a evidência ligada a duplicação de frames deve ser armazenada com horário, origem e condição de teste, permitindo comparação posterior.
- PRP · visão geral · zero recovery time: Definir janela, direção, tamanho/amostragem e carga do teste.
- PRP · visão geral · LAN A: Registrar percentis e máximos; não aceitar somente média.
- PRP · visão geral · LAN B: Para perda, registrar comprimento das rajadas e não só percentual global.
- PRP · visão geral · duplicação de frames: Converter a métrica em consequência observada no serviço de automação.
PRP: duplicação, sequência e tempo de recuperação — PRP / visão geral
Para entender PRP sem abstração excessiva, acompanhe supervision frames da origem ao consumidor e marque a fronteira em que seu estado pode mudar. PRP envia o mesmo frame pelas LAN A e B e o receptor elimina duplicatas; a vantagem é não esperar reconvergência quando uma LAN falha. HSR duplica o tráfego nos dois sentidos do anel e também elimina a cópia redundante no destino. Em ambos, o teste relevante mede a continuidade da aplicação durante a retirada física de um caminho, e não apenas o estado das portas. Se supervision frames não reproduzir o comportamento esperado em PRP, a hipótese deve ser revista antes de alterar outra camada do sistema.
A visão geral de PRP fica útil quando zero recovery time é ligado ao fluxo físico/lógico real, e não apenas a uma definição de glossário. Para PRP, registre sequência dos frames redundantes, caminho de chegada, contadores de duplicatas/descartes e o maior gap de aplicação durante a falha. Em PRP, o Redundancy Control Trailer (RCT) identifica informações como sequence number e LAN identifier; em HSR, a identidade/sequência do quadro permite descartar duplicatas. Um desenho redundante só está comprovado quando a perda de um caminho não cria timeout perceptível no protocolo protegido. O critério de encerramento para PRP em visão geral é obter o mesmo resultado em novo teste de zero recovery time, mantendo o ponto de medição e a condição inicial.
- PRP · visão geral · SAN: Capturar antes e depois da remoção da LAN/caminho e medir o maior intervalo entre frames úteis.
- PRP · visão geral · RedBox: Conferir counters de duplicatas, frames únicos e erros por LAN/porta.
- PRP · visão geral · supervision frames: Validar que LAN A e B são realmente independentes em switch, alimentação e caminho físico.
- PRP · visão geral · duplicate discard: Testar retorno do caminho sem tempestade, loop ou alteração indevida de sequência.
Continue estudando
Os próximos conteúdos foram escolhidos para formar uma sequência técnica, relacionando fundamento, configuração, diagnóstico e aplicação.