
Retries no IEC 101: repetição confirmada, FCB/FCV e impacto no ciclo
Entenda quando repetir no IEC 101, como FCB e FCV evitam duplicidade, limites de tentativas, backoff, comandos e testes de recuperação.
Política de repetição IEC 101
| Situação | Ação | Evidência de segurança |
|---|---|---|
| Solicitação perdida | repetir conforme limite | mesmo estado FCB/FCV |
| Resposta perdida | repetir transação confirmada | sem reprocessamento |
| RTU silenciosa | limitar e seguir o ciclo | outras RTUs atendidas |
| Comando incerto | consultar estado antes de reenviar | retorno e SOE |
| Retorno do canal | escalonar recuperação | backlog drenado |
Retry deve ser dimensionado junto com timeout e ciclo total.
Retry recupera incerteza, mas consome capacidade
A repetição é útil quando solicitação ou resposta pode ter se perdido, porém cada tentativa ocupa o barramento e atrasa outras estações. Em canal saudável, retries devem ser raros e mensuráveis. Frequência crescente indica degradação, não condição a ser mascarada aumentando o limite. A política define quais funções podem repetir, quantas vezes, em que intervalo e como a estação é tratada depois do limite, mantendo serviço às demais.
FCB e FCV preservam identidade da transação
Frame Count Bit e Frame Count Valid ajudam a secundária a reconhecer repetição de frame confirmado. Quando a primária reenvia a mesma transação por perda de resposta, o estado apropriado evita que o serviço seja processado como novo. A alternância só ocorre para nova solicitação conforme o procedimento. Capturas devem acompanhar PRM, função, FCB e FCV por endereço; analisar apenas conteúdo da ASDU não mostra se houve duplicata ou avanço legítimo.
Reset de link redefine expectativas
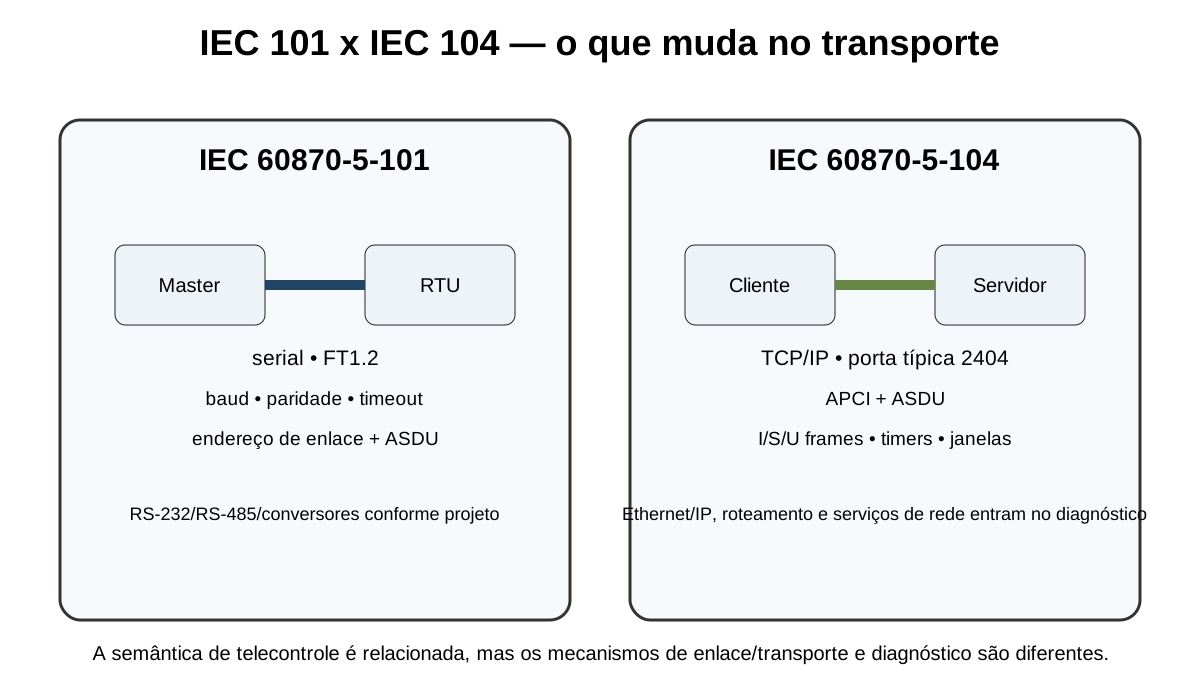
Após inicialização, falha prolongada ou inconsistência, funções de reset e status restabelecem estado de enlace. O procedimento precisa ser compatível nas duas pontas. Se uma estação perde o estado de FCB e a outra continua, novos frames podem ser tratados como repetição ou o inverso. Teste restart de cada lado, perda da resposta ao reset e retorno do meio. A recuperação deve terminar em estado conhecido antes de liberar funções operacionais.
Número de tentativas altera o pior caso
Com N estações, timeout longo e várias repetições por RTU, uma contingência pode multiplicar o ciclo. Calcule o tempo para abandonar uma secundária e o impacto acumulado. Criticidade não justifica retry infinito: dados atrasados podem perder valor operacional. Muitas arquiteturas preferem poucas tentativas rápidas, alarme e reconsulta posterior, mas a decisão deve considerar meio, processo e requisitos, documentando o comportamento exato do driver.
Backoff reduz tempestade na recuperação
Quando o canal retorna, todas as estações e funções podem tentar recompor estado, eventos e GI. Repetições imediatas sem escalonamento aumentam colisão ou filas. Use política de redistribuição e limite concorrência no gateway. Em rádio compartilhado, coordene acesso ao canal. Meça backlog e tempo até normalização. O objetivo não é apenas “ficar online”, mas recuperar informação preservada sem saturar o caminho nem atrasar comandos urgentes.
Comando exige tratamento conservador
Timeout depois de um comando deixa estado incerto: a RTU pode ter executado e a resposta ter sido perdida. Repetir automaticamente pode causar nova atuação. Use confirmação protocolar, retorno de posição, SOE e intertravamentos para determinar resultado. Quando o serviço é protegido por FCB/FCV, teste a implementação real, mas não substitua filosofia operacional por suposição. Procedimento de contingência deve orientar operador e registrar cada tentativa.
Contadores separam falha episódica de tendência
Registre tentativas por estação, função, período e causa: timeout, checksum, negativa, conexão ou reset. Uma média global esconde RTU problemática. Correlacione com nível de sinal, erros seriais, ocupação e horário. Alertas devem considerar taxa e persistência. Depois de manutenção, compare com baseline. Retry zero não é objetivo absoluto em meio sujeito a erro; o objetivo é manter taxa compatível com confiabilidade e detectar mudança antes de indisponibilidade.
Ensaio prova ausência de duplicação
Perda controlada da solicitação, da resposta e de bytes intermediários produz cenários diferentes. Capture nas duas pontas e confirme FCB/FCV, número de execuções e resposta. Repita com leitura, classe, GI e comando simulado. Reinicie primária e secundária separadamente. O aceite exige que a estação saudável não fique bloqueada, que a indisponível seja retomada de forma previsível e que nenhuma operação física seja duplicada por uma incerteza de comunicação.
Critério de engenharia e governança
A política também deve diferenciar repetição de consulta e repetição de recuperação. Leituras idempotentes admitem nova solicitação com menor risco, enquanto comandos e funções de estado exigem confirmação e investigação. Para cada Function Code usado, classifique efeito, mecanismo de duplicidade e evidência necessária antes de reenviar. Em gateways, confira se o retry externo não se soma a retries internos e multiplica tentativas sem visibilidade; uma solicitação do SCADA pode gerar várias transmissões em cada segmento. Ajuste limites de modo que a soma ainda respeite o ciclo. Alarmes precisam separar “recuperado na segunda tentativa” de “estação abandonada”, permitindo acompanhar tendência. Na manutenção, não zere contadores antes de coletar baseline. Teste também a perda do ACK após processamento, o cenário mais propenso a duplicidade aparente. O resultado esperado deve declarar quantas vezes a função foi recebida, processada e respondida. Essa contabilidade transforma retry em mecanismo controlado de confiabilidade, evitando que repetição automática se torne causa de saturação ou atuação indevida.
Referências técnicas e normas
As explicações do Portal são autorais. Normas e fontes oficiais são priorizadas; materiais acadêmicos e documentação pública de fabricantes complementam a implementação e não substituem a edição normativa aplicável ao projeto.
- IEC 60870-5-104:2006+AMD1:2016 CSV — Network access for IEC 60870-5-101 — IEC. Companion standard consolidado do IEC 104; inclui o corrigendum publicado em 2023.
- IEC 60870-5-101:2003+AMD1:2015 CSV — Basic telecontrol tasks — IEC. Companion standard consolidado do IEC 101 para telecontrole serial.
- IEC 60870-5-1:1990 — Transmission frame formats — IEC. Formatos de quadro e requisitos de integridade usados pela família IEC 60870-5.
- IEC 60870-5-2:1992 — Link transmission procedures — IEC. Procedimentos de transmissão da camada de enlace, especialmente pertinentes ao IEC 101.
- IEC 60870-5-3:1992 — General structure of application data — IEC. Regras para estruturar unidades de dados de aplicação.
- IEC 60870-5-5:1995 — Basic application functions — IEC. Funções básicas de aplicação, incluindo aquisição, comandos e sincronização.
- IEC 60870-5-6:2006 — Guidelines for conformance testing — IEC. Método para ensaios de conformidade dos companion standards IEC 60870-5.
- IEC TS 60870-5-601:2015 — Conformance test cases for IEC 101 — IEC. Casos de ensaio de conformidade para implementações IEC 101.
- IEC TS 60870-5-604:2016 — Conformance test cases for IEC 104 — IEC. Casos de ensaio positivos e negativos para implementações IEC 104.
- IEC TS 60870-5-7:2025 — Security extensions for IEC 101/104 — IEC. Extensões de segurança alinhadas à série IEC 62351 para autenticação, integridade e RBAC.
- IEC 61850-6:2009+AMD1:2018+AMD2:2024 CSV — IEC. Edição consolidada 2.2 da System Configuration description Language (SCL).
Continue estudando
Os próximos conteúdos foram escolhidos para formar uma sequência técnica, relacionando fundamento, configuração, diagnóstico e aplicação.